Lo que todo desarrollador de IA debe saber sobre recopilar datos en internet
El Comité Europeo de Protección de Datos acaba de publicar unas directrices específicas sobre web scraping aplicado a inteligencia generativa. Hasta ahora, esta práctica se trataba de forma dispersa en otros documentos. Ahora tienes un mapa claro de qué exige la ley cuando extraes datos automatizados de internet para entrenar modelos de IA.
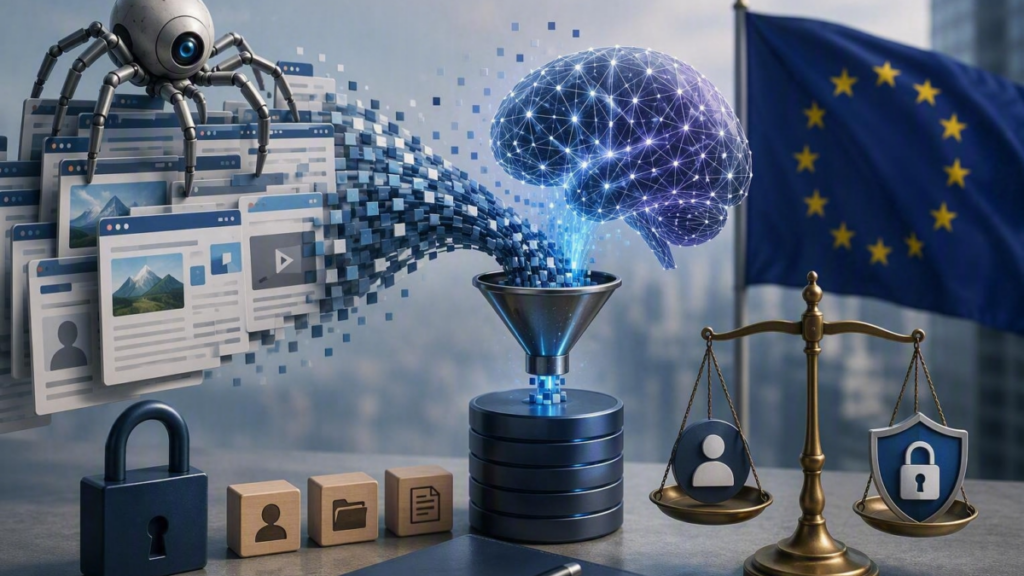
El web scraping es simple en concepto: un software recorre sitios web públicos y extrae información masivamente. Registros oficiales, medios de comunicación, redes sociales, blogs. El problema es que muchos de estos sitios contienen datos personales, a menudo sin que ni siquiera lo sepas con precisión. Cuando usas esos datos para entrenar modelos generativos —sistemas diseñados para producir contenido nuevo basándose en patrones aprendidos—, entras en territorio regulado.
Las nuevas directrices distinguen entre dos enfoques. El scraping dirigido sigue criterios concretos: extraes todas las URLs de un dominio específico, o solo contenido en un idioma determinado. El scraping no dirigido es más agresivo: el software sigue cada enlace que encuentra sin límites, rastreando enormes porciones de internet. Este segundo método multiplica el riesgo: acabas recogiendo datos que ni identificaste ni necesitas.
Las fases que debes documentar
El regulador europeo desglosa el proceso en cuatro etapas secuenciales. Primero, defines los criterios de recopilación. Segundo, ejecutas la extracción. Tercero, limpias los datos brutos. Cuarto, estructuras y almacenas el dataset resultante. Cada fase genera obligaciones específicas de cumplimiento. No es una descripción teórica: son requisitos que deben reflejarse en tu documentación.
Un aspecto crítico es quién es responsable ante la ley. Si tu organización encarga a un tercero que recopile datos según tus instrucciones documentadas, ese tercero actúa como encargado y tú conservas la responsabilidad. Si compras un dataset ya preparado por otro, cada uno responde separadamente de su propio tratamiento. Pero cuidado: si dos organizaciones deciden conjuntamente desarrollar un modelo y distribuyen tareas de scraping y entrenamiento, pueden resultar corresponsables.
Transparencia y minimización de datos
El CEPD reconoce que cuando rastreas volúmenes enormes de fuentes distintas, informar individualmente a cada persona afectada es imposible o costoso desproporcionadamente. La ley lo contempla: puedes no hacerlo, siempre que documentes que evaluaste el número de afectados, la antigüedad de los datos y las protecciones que aplicaste.
Sobre minimización, hay un mito que conviene desmontar: no está prohibido entrenar con grandes volúmenes de datos. Lo que exige la ley es que no recopiles datos personales innecesarios, inadecuados o irrelevantes para tu objetivo. Eso requiere planificación previa. Antes de empezar, evalúa si puedes usar datos sintéticos en lugar de reales, define criterios precisos de recopilación, filtra categorías sensibles —datos bancarios, de geolocalización— y excluye sitios que sirven principalmente a menores.
También debes respetar los indicadores técnicos de oposición: ficheros robots.txt, archivos ai.txt y CAPTCHA. El CEPD los interpreta como señales claras de que el sitio rechaza el rastreo automatizado. Ignorarlos es un problema serio.
El detalle importa. Muchas organizaciones descubren tarde que su práctica no cumple. Las directrices dibujan el camino. Intégralas en tu proceso desde la fase más temprana de obtención de datos, no cuando ya tienes los datos recopilados.