Disparidad en las pruebas de acceso docente: por qué el modelo actual no mide lo que debería
La brecha entre lo que ocurre en la primera prueba de las oposiciones a maestro y lo que sucede después es llamativa. Mientras que en algunas especialidades apenas uno de cada cuatro presentados supera el primer filtro, quienes logran pasar demuestran después capacidad real para el puesto. Esto no es un detalle: es un síntoma de que el sistema no está calibrado correctamente.
Los números son elocuentes. En Inglés aprobó la primera prueba el 24,52% de los aspirantes. Sin embargo, de quienes llegaron a la segunda, el 96,13% la superó. En Audición y Lenguaje, el 28,07% pasó el primer filtro, pero luego el 86,9% aprobó la siguiente. Esta disparidad se repite en todas las especialidades, con tasas de aprobado en la segunda prueba que oscilan entre el 82% y el 97,5%.
¿Qué significa esto? Que la primera prueba está eliminando a muchos candidatos que realmente tienen capacidad para enseñar. El modelo actual, regulado por el Real Decreto 276/2007, se comporta como un embudo innecesariamente estrecho al inicio, cuando debería permitir que avanzasen quienes verdaderamente poseen competencias profesionales.
Hay otro aspecto que debes tener en cuenta: el desajuste entre plazas ofertadas y personas cualificadas. En Audición y Lenguaje no se cubrieron las 25 plazas convocadas en turno libre, y en el turno de reserva para personas con discapacidad quedaron sin cubrir 86 vacantes. Esto ocurre mientras miles de aspirantes se quedan fuera en la primera prueba.
Un error frecuente es pensar que una selectividad muy restrictiva garantiza mejor calidad. En realidad, cuando ves que quienes pasan el primer corte demuestran competencia en el segundo, lo que ocurre es que estás filtrando de manera ineficiente. No estás identificando incompetencia; estás creando ruido que afecta al acceso.
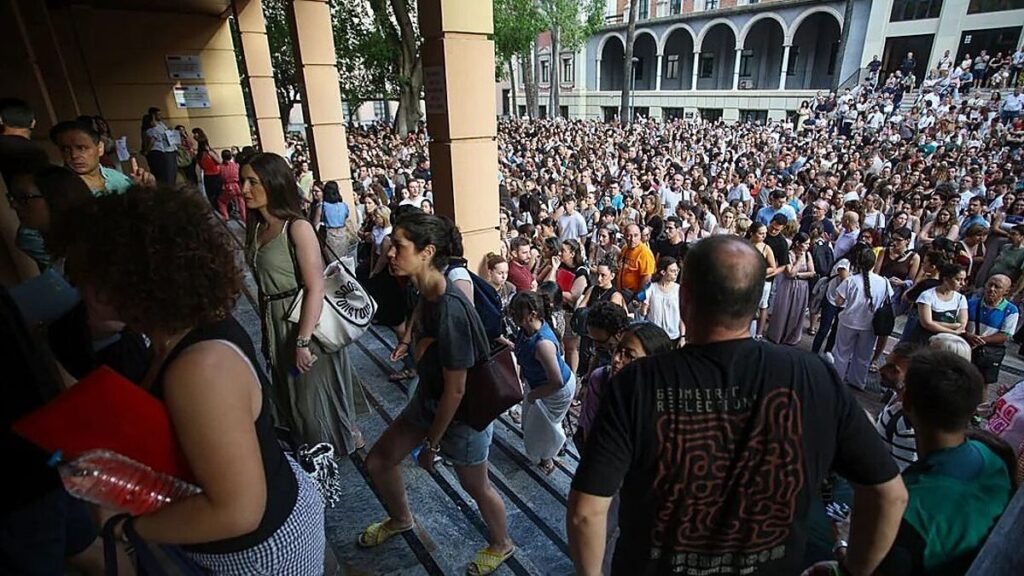
También surgen críticas sobre cómo se ha gestionado el proceso. Los problemas organizativos durante la celebración de las pruebas, especialmente en el acceso al lugar de examen, generaron incertidumbre y retrasos. Cuando un proceso selectivo presenta fallos en su ejecución, la fiabilidad de los resultados se pone en duda.
La cuestión de fondo es si el modelo actual mide realmente lo que importa: la capacidad de enseñar. Los datos sugieren que no. Una reforma tendría que replantear qué evalúa cada fase y cómo se ponderan los resultados para que el sistema funcione como una herramienta de selección, no como un cuello de botella.